Modèle à tester : ShayanCyan/phi4-multimodal-quantisized-gguf
-
https://huggingface.co/asuglia/Qwen2-VL-2B-Instruct-Q4_K_M-GGUF => Non.

unsloth/Qwen3-VL-8B-Thinking-GGUF · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
(huggingface.co)

ShayanCyan/phi4-multimodal-quantisized-gguf at main
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
(huggingface.co)
-
Configuration :
"Best_phi4-mm-Q4_K_M.gguf_mmproj-vision-q8.gguf": proxy: http://127.0.0.1:8998 capabilities: context: 128000 name: "Best_phi4-mm-Q4_K_M" description: "-m /models/phi4-mm-Q4_K_M.gguf --mmproj /models/phi4-mm-vision-q8.gguf --ctx-size ${default_ctx} --temp ${temp} --top-p 0.95 --top-k 40 --min-p 0.05 --host 0.0.0.0 --fit off -ngl 40 --port 8998" cmd: /usr/local/bin/llama-server -m /models/phi4-mm-Q4_K_M.gguf --mmproj /models/phi4-mm-vision-q8.gguf --ctx-size ${default_ctx} --temp ${temp} --top-p 0.95 --top-k 40 --min-p 0.05 --host 0.0.0.0 --fit off -ngl 40 --port 8998 -fa on --flash-attn on aliases: - "best-phi4-mm" - "llama-swap-phi4" macros: "default_ctx": 128000 "temp": 0.7 metadata: temperature: ${temp} note: "The ${MODEL_ID} is running on port 8998 temp=${temp}, context=${default_ctx}" env: - "NVM_BIN=/root/.nvm/versions/node/v24.17.0/bin" - "NVM_DIR=/root/.nvm" - "NVM_INC=/root/.nvm/versions/node/v24.17.0/include/node" - "PATH=/root/.nvm/versions/node/v24.17.0/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin" - "CUDA_DEVICE_ORDER=PCI_BUS_ID" ttl: 60 -
Reduction de la mémoire pour que cela puisse se lancer :
  "Best_phi4-mm-Q4_K_M.gguf_mmproj-vision-q8.gguf":
   proxy: http://127.0.0.1:8998
   capabilities:
     context: 100000
   name: "Best_phi4-mm-Q4_K_M"
   description: "-m /models/phi4-mm-Q4_K_M.gguf --mmproj /models/phi4-mm-vision-q8.gguf --ctx-size ${default_ctx} --temp ${temp} --top-p 0.95 --top-k 40 --min-p 0.05 --host 0.0.0.0 --fit off -ngl 40 --port 8998"
   cmd: /usr/local/bin/llama-server -m /models/phi4-mm-Q4_K_M.gguf --mmproj /models/phi4-mm-vision-q8.gguf --ctx-size ${default_ctx} --temp ${temp} --top-p 0.95 --top-k 40 --min-p 0.05 --host 0.0.0.0 --fit off -ngl 40 --port 8998 -fa on --flash-attn on --n-cpu-moe 25
   aliases:
     - "best-phi4-mm"
     - "llama-swap-phi4"
   macros:
     "default_ctx": 100000
     "temp": 0.7
   metadata:
     temperature: ${temp}
     note: "The ${MODEL_ID} is running on port 8998 temp=${temp}, context=${default_ctx}"
   env:
     - "NVM_BIN=/root/.nvm/versions/node/v24.17.0/bin"
     - "NVM_DIR=/root/.nvm"
     - "NVM_INC=/root/.nvm/versions/node/v24.17.0/include/node"
     - "PATH=/root/.nvm/versions/node/v24.17.0/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"
     - "CUDA_DEVICE_ORDER=PCI_BUS_ID"
   ttl: 60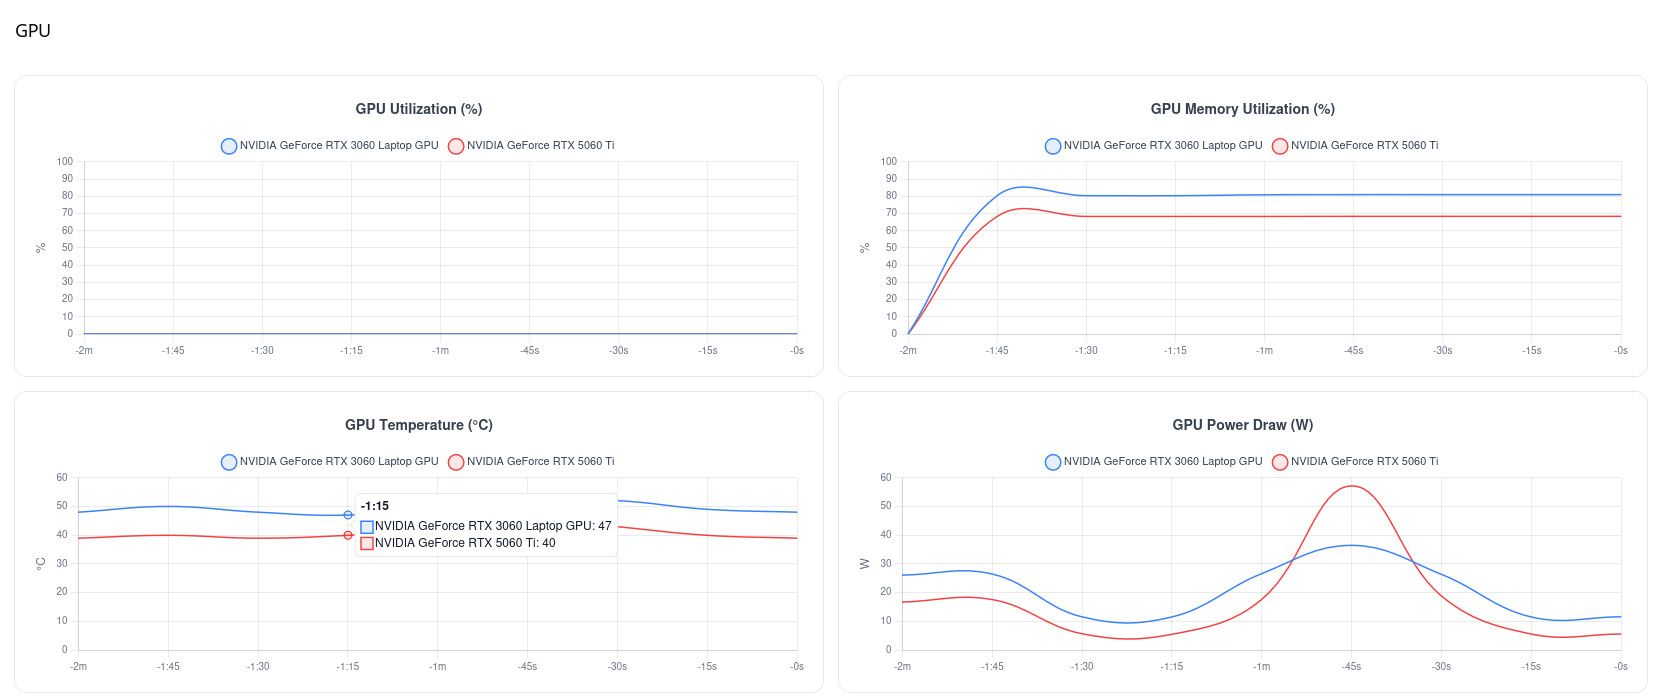


Bonjour ! Vous semblez intéressé par cette conversation, mais vous n’avez pas encore de compte.
Marre de refaire défiler les mêmes messages ? Créez un compte pour retrouver votre position, recevoir des notifications des nouvelles réponses, sauvegarder vos favoris et voter pour les messages que vous appréciez.
Grâce à votre participation, ce message peut devenir encore meilleur 💗
S'inscrire Se connecter